12.1 观测是输入,不是动作
一条多轮轨迹(trajectory)交错着两种 token。策略 token(policy tokens)由 采样得到;它们是动作,第 6 章 的策略梯度(policy gradient)是对它们求和。观测 token(observation tokens)——工具输出以及包围它的模板 token——由环境(environment)产生;策略以它们为条件,但从未选择过它们。第 6.1 节的推导把这一结论表述得很精确:环境的转移概率不依赖于 ,因此它们的对数概率会从 中消去;而作用在观测 token 上的损失项将是朝向预测环境的梯度,那是另一个目标。第 5 章 的动作掩码(action mask)保证了这一点。我们直接检查:在一个批次上计算策略梯度损失,对 logits 求导,并按 token 的归属统计哪些位置得到了梯度。logits 张量各位置的梯度:只有策略位置非零,提示、模板和工具位置都为零。这不表示上下文表征没有梯度;它们仍会影响后续策略 token 的预测。回合越长,这个不变量越重要,因为策略所写内容在上下文中的占比会缩小。我们以 6、12 和 24 的轮次预算运行 RL 基座智能体,测量这一占比、上下文长度,以及回合因下一次调用放不进 TinyAgent 的 256-token 上下文而结束的频率。
12.2 跨轮次的回报归因
在结果奖励和组基线(baseline)下,一个回合的每个策略 token 都得到相同的优势(advantage)(第 7.6 节)。关键编辑若要比无用的test 获得更强的正向反馈,唯一的途径是跨回合比较:无用的调用在成功和失败中都会出现,因此平均而言它的概率不会改变。逐轮奖励(per-turn reward)让这个问题更尖锐。若每次调用的代价为 ,一个包含 次调用、以判定 结束的回合,其回报(return)为
并且一次调用的代价在它发生的那一刻就已知。结果优势 仍然把总量分摊到所有调用上。由 和每次调用开始时的价值 构造的轮级优势 ,原则上可以让每次调用只承担它自己的代价,并因它所引起的价值变化而获得正向反馈。per_call_rewards 把 铺到 token 上:每次调用的最后一个 token 上为 ,回合的最后一个策略 token 上为判定结果。masked_whiten 在策略 token 上对优势做归一化,正如 PPO 实现对 GAE 优势所做的那样(第 8.4 节)。
train_credit 就是把优势计算替换为基于 critic 的版本的 train_rl:逐调用奖励、critic 价值、token 级或轮级的 GAE、白化、相同的裁剪更新,以及一步 critic 更新。
test 调用(每个留出回合 0.01 次),但也学到了我们不想要的东西:它只在 78% 的回合中执行编辑,在没有把握时读完就不编辑直接提交,因为调用更少的失败代价更低,其留出通过率为 0.656。两组基于 critic 的实验保留了更多零成本时的习惯:token 级 GAE 几乎在每个回合都保留了测试(0.97 次测试),轮级 GAE 约在三分之一的回合中保留(0.29),而两者通过的留出回合都更多,分别为 0.787 和 0.769。与一个解释方差只有百分之几的 critic 的噪声相比(第 7.4 节),每轮 0.05 的代价很小,因此基于 critic 的实验基本忽略了它;而结果级 GRPO 的组内比较则直接看到了它——在同一任务的、长度不同的回合之间。
证据。 本书测得,每组一个随机种子,40 步。各组在tests上的差异并不稳健:在仅浮点求和顺序(线程数)不同的探索性运行中,token 级 GAE 也去掉了test调用。这一比较所支持的是机制:只有当 critic 分辨出某次调用的代价时,轮级或 token 级优势才能让这次调用只承担它自己的代价;而结果优势会让更长回合中的每一次调用都为长度买单。图 12.1 展示了一个回合的轮级归因。
 图 12.1 通过轮级 GAE 策略自己的 critic 来解读它的一个回合(read、
fix_comparison、test、submit)。每次调用代价 0.05,submit 带有判定结果。critic 给出的时序差分(TD)误差把阅读和关键编辑评为负向改进(−0.116 和 −0.031),而无用的测试和提交提高了价值(+0.070 和 +0.305):40 步之后,critic 分配学习信号的方向仍然几乎是反的,就像第 7 章的 critic 一样。在 下,轮级优势把后面的 TD 误差串联回来,于是每次调用最终都为正,从阅读的 +0.180 到测试的 +0.361。同一回合上的 token 级 GAE 还会在每次调用内部变化,在编辑内部最多变化 0.17,这个例子中的调用内差异来自 critic 的估计噪声。这个例子暴露了轮级 GAE 的限制:它依赖调用边界处的价值估计,而这里的 critic 只见过几百个二值结果,估计还不够准确。
12.3 轮次预算与步惩罚
有两个数字决定了智能体可以做多少事:轮次预算(turn budget,max_turns),这是一个硬上限,到达后回合以未提交状态结束;以及步惩罚(step penalty),这是以奖励为单位的每次调用的软代价。第 2.9 节 精确求解了修复 MDP,发现代价不超过 0.3 时最优策略保持其形态,超过 0.4 时则放弃。学习中的智能体面对的并不是最优策略的权衡,而是它自己的权衡:只有当策略当前对某次调用的使用能把期望判定提高得比代价更多时,这次调用才值得付费。我们用 3 轮(而不是 6 轮)的预算训练默认配置,再用 0.3 的步惩罚训练,并与默认配置以及第 12.2 节的 0.05 惩罚进行比较。每组实验都使用隐藏测试判定、RL 基座智能体和 40 步。
test,因为它没有代价。每次调用 0.05 的惩罚去掉了测试,连带去掉了一部分编辑(第 12.2 节)。0.3 的惩罚产生了第 2.9 节中的退化智能体:它在每个留出回合的第一次调用就提交,通过率为 0,奖励为 −0.30,即一次调用的代价。而 3 轮的预算产生了一个盲猜者:不阅读,一次编辑,一次提交,通过率为 0.200,恰好等于 第 9.4 节 中最好的单一盲猜操作。阅读、编辑、提交正好放得进 3 轮,但没有任何余量:初始策略中少见的阅读回合几乎总是在提交前耗尽轮次,因此阅读的收益低于盲猜,最终被消除。(在一次仅线程数不同的探索性运行中,3 轮实验确实学会了阅读,并达到 0.41;没有余量的预算会让结果取决于早期的运气。)
 图 12.2 展示了动态过程。在 0.3 的惩罚下,轮次在大约 10 步内塌缩到 1,通过率根本来不及上升。在 3 轮预算下,阅读在最初 10 步内降到 0,而通过率停留在盲猜上限 0.2 附近。默认配置在第 12 步左右冲高到每回合约 1.4 次阅读,然后稳定在 1。0.05 的惩罚学会阅读更慢,直到第 25 步左右才达到每回合一次阅读,因为每次阅读在其收益被学会之前就被收费了;它的
tests 起初与默认配置一起上升,然后在第 27 步之后塌缩——此时阅读已经确立,测试成了唯一一个花了代价却买不到任何东西的调用。代价在技能已经存在时塑造技能如何被执行;代价较小时会减慢技能的发现,相对于初始策略的成功率而言代价较大时则会阻止技能的发现。
12.4 上下文管理改变策略的输入
长回合最终会放不进上下文窗口。生产环境中的智能体主要用三种方式管理上下文:截断(truncation,丢弃最早的轮次)、观测掩蔽(observation masking,保留每次调用,但用占位符替换旧的工具输出),以及摘要(summarization,用模型写的摘要替换一段历史)。Lindenbauer et al.(2025)报告,对于 SWE-bench Verified 上的 SWE-agent,简单的观测掩蔽相对于原始智能体把成本减半,且解决率与 LLM 摘要持平。无论用哪种方法,它都改变了策略所依赖的条件,因此也改变了 第 5 章 的单序列视角视为理所当然的两件事。 第一,输入分布变了。用完整历史训练的策略从未见过源代码处被占位符替换的历史。第二,一个回合不再是一条序列。在完整上下文下,第 次调用的前缀就是第 次调用前缀的一部分,所以在整个回合上做一次前向传播就能为每次调用打分。在掩蔽下,第 次调用是从一个与第 次调用所见不同的前缀生成的,因此每次调用都是一个单独的(提示,补全)样本,训练器(trainer)必须在采样器所用的完全相同的前缀下为每次调用打分;否则,它计算的就是 token 在从未产生过它们的上下文下的概率——它与第 5.4 节的重分词漂移(retokenization drift)有同样的后果:训练时打分的条件不再等于采样时的条件。context_view 在 Episode 的 token 日志上实现观测掩蔽:在第 次调用之前,它丢弃比最后 keep_obs 轮更早的每一轮的工具 token,保留 <obs> </obs> 模板 token 作为占位符。keep_obs=None 表示完整上下文。
context_rollout_batch 就是第 5 章的同步(lockstep)采样器,只有一处改动:每次调用都从截至当前的回合的 context_view 生成,并记录(视图,调用)对。它返回完整的回合(用于统计),以及逐调用样本(用于训练),每个样本都标注了其所属回合的索引。
keep_obs=None 且使用相同生成器时,采样器必须精确复现 rollout_batch;而逐调用样本分别打分时,必须给出与把回合作为单条序列打分相同的对数概率。
token_mean 聚合下,这与单序列更新的目标相同:相同的 token、相同的优势、相同的归一化因子。只有上下文不同。
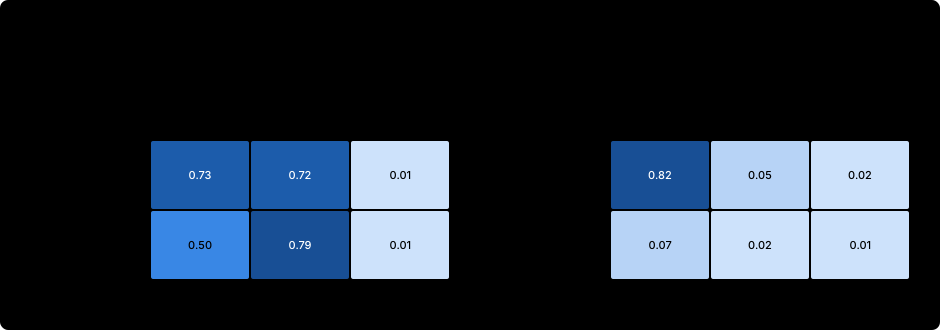
evaluate_context 在给定的上下文策略下采样留出回合。我们把两种训练条件——完整上下文(第 12.3 节的默认运行)和 keep_obs=1 的观测掩蔽——与三种评估条件交叉:完整、keep_obs=1,以及移除所有工具输出的 keep_obs=0。
keep_obs=0)时,两者都完全失败,这证实了信息来自观测。context_rollout_batch 的默认设置是完整上下文,第 5 章的采样器仍是本书的默认做法;任何上下文策略都必须在训练和评估中以完全相同的方式应用,图 12.3 对此做了总结。
12.5 工具错误、格式错误的调用与提前终止
一次调用可能以三种方式失败:无法解析(缺少参数的<call> edit </call>),指定了不存在的工具或参数,或者调用有效但工具失败(测试运行崩溃、超时)。对前两种情况,gym 返回一个错误观测并消耗一轮,这也是大多数智能体评测框架(harness)的设计;例如,Model Context Protocol 把工具失败作为标记了 isError 的结果返回,使模型能看到并从中恢复(第 4.7 节)。另一种做法是提前终止(early termination):一出错就结束回合,并判为失败。它节省了一个已经出错的回合的计算量,对格式错误的输出给出更尖锐的信号,但也消除了学习恢复的任何机会。EarlyStopEnv 在出现 max_invalid 次错误后以未提交状态结束回合。
make_reward(invalid_penalty=...)——它们才会在 RL 下消失。
12.6 混合单轮与多轮数据
智能体后训练很少只使用智能体回合。单轮数据(一个包含全部信息的提示和一个答案,如数学 RLVR 或根据规格说明生成代码)采样更便宜,没有环境延迟,并且教授的是同一种底层技能。BugFix 版本的单轮任务在提示中给出源代码,并对第一次调用评分:single_turn 把源代码的阅读投影追加到问题描述之后,MixedTurnEnv 在一次调用之后就对这类任务评分(视为已提交),同时把其他所有任务作为正常回合运行。环境通过检查任务来做出判断,因此一个工厂即可服务于混合批次。
token_mean 下,一个回合的权重与其策略 token 数成正比(第 6.6 节),而单轮回合只有一次调用,多轮回合约有四次。下面的代码从混合策略采样一个包含每种格式各 4 个任务的批次,并测量单轮回合在 token_mean 和逐序列平均下所获得的损失权重占比。
token_mean 损失权重的 19%,因为每个单轮回合只有一次调用,而多轮回合约有四次。逐序列平均会给它们 50%。因此,对梯度而言重要的混合比例是策略 token 的比例,而不是回合的比例,并且随着训练中多轮回合变短或变长,这个比例也会移动。
12.7 实践中的设计问题
问题:智能体学会立即提交。 现象: 每回合轮次降到 1,通过率降到 0,奖励稳定在负的单步代价。 原因: 在步代价为 时,一次需要 次调用、以概率 通过的尝试价值为 ,而立即提交的价值为 。策略是在它当前的 和 下比较两者,而不是在最优值下比较,因此训练好的智能体负担得起的代价(在第 2.9 节的 MDP 中,最优策略只有在代价超过 0.4 时才放弃),对于 的初始策略却是毁灭性的。 可选方案: (a)小得多的代价,或在通过率变高之前不设代价。(b)在训练过程中逐步引入的代价。(c)只对超出免费额度的调用收取代价。(d)把代价作为单独的指标报告,并据此选择检查点,而不是在它上面训练。 建议做法: 先(a)后(b),并用下面的算术针对初始策略进行核验。第 12.3 节中 0.3 惩罚的运行就是这个问题的复现。
问题:智能体从不提交。
现象: 提交率下降,回合跑满轮次上限,奖励朝 0 上升而通过率不升。
原因: 被轮次上限终止的回合会被奖励函数判为未提交,在隐藏测试判定下其值为 0。如果错误的提交受到惩罚(这里为 ),那么在当前通过率下,不提交比提交更安全,策略就会学会耗尽预算。无论是否有人刻意设计,截断的结果都是奖励的一部分。
可选方案: (a)让未提交的回合至少和失败的提交一样差。(b)把被截断的回合排除在更新之外(见下一个问题)。(c)永远不要把失败惩罚到低于截断的值。
建议做法: (a):耗尽轮次的结果应当是所有可能结果中最差的。我们用 wrong_submit=-1 训练并记录提交率。
问题:因超时而被截断的回合。 现象: 轮次或 token 上限紧张的运行学得慢、学会仓促行事,或者(如上所示)学会拖延;改变上限会改变学到的行为。 原因: 被截断的回合没有判定。把它记为失败(gym 的默认做法)会让智能体学习这个上限;用其他方式记分则是对上限含义的一种选择。Pardo et al.(2018)区分了两种情况:如果上限是任务的一部分,剩余时间就应当放进智能体的输入,截断是真正的终止结果;如果上限只是为了让训练可行而存在,智能体就应从回合被截断处状态的价值进行自举(bootstrap),,这需要一个 critic。 可选方案: (a)把截断视为失败,并在观测中展示剩余预算。(b)把被截断的回合从损失中掩蔽掉,正如 DAPO 的超长过滤和 DeepSWE 的紧凑过滤所做的那样(第 20 章)。(c)用 critic 自举。 建议做法: 当上限属于任务本身时(一个有真实截止时间的编程智能体)用(a);只有当上限是策略无法用来规避惩罚的工程上限时才用(b);只有当 critic 的解释方差经过测量时才用(c)。下面的代码在从不提交的设置下重新训练,并掩蔽被截断的回合:它们的优势设为 0,组基线只使用提交了的回合。
submit 的概率,没有任何东西把它推回去。拖延变得免费了。掩蔽被截断的回合消除了反对截断的信号——对于那些在仍有进展时被截断的回复,这正是 DAPO 超长过滤的本意;而当截断是策略可以主动做出的选择时,策略就会利用这一点。只有当策略无法以比认真工作更低的代价故意触发截断时,或者另外对截断设置代价时,才使用(b)。
问题:上下文溢出。
现象: 少数长回合在任何判定之前就以 stop='truncated' 结束,最长的序列上出现内存峰值,长时程任务的失败率高于其难度所预示的水平。
原因: 上下文随每个观测增长;在真实环境中工具输出没有上界(第 4.8 节),而窗口——这里是 256 个 token——是固定的。第 12.1 节测量了风险如何随轮次预算增长。
可选方案: (a)为每个观测设上限(保留头部和尾部,并加入标记)。(b)观测掩蔽或摘要(第 12.4 节),这会把一个回合变成逐调用样本,并改变输入分布;要用与部署时相同的上下文策略进行训练。(c)更大的窗口,代价是内存和注意力计算开销。(d)把溢出视为截断,并应用上一个问题的规则。
建议做法: 始终使用(a);一旦回合经常超出窗口就使用(b);并且严格在训练所用的上下文策略下进行评估,第 12.4 节已表明这一点不是可选的。
小结
- 观测 token 是输入:在一个真实批次上的策略梯度损失给全部 201 个策略位置都带来了非零梯度,而 669 个提示、模板和工具位置一个也没有。BugFix 回合中只有 30% 的 token 属于策略;在长的 SWE 回合中只有百分之几。
- 在逐调用代价下,结果级 GRPO 通过比较不同长度的回合去掉了无用的
test调用,同时也学会了在没有把握时跳过编辑(留出 0.656);基于 critic 的 token 级和轮级 GAE 保留了更多无用调用,通过得也更多(0.787、0.769)。只有当 critic 分辨出某次调用的代价时,轮级优势才能让这次调用只承担它自己的代价。 - 代价和预算会从同一个初始策略中选出不同的智能体:0.3 的步惩罚让智能体立即提交(通过率 0),而没有余量的 3 轮预算消除了阅读(通过率 0.200,即盲猜上限)。要把代价与初始策略的成功率比较,而不是与最优策略的比较。
- 上下文管理让每次调用都成为单独的样本,必须在采样器所用的完全相同的上下文下打分(验证到 );它还改变了输入分布:用掩蔽上下文训练的策略在完整上下文下评估,从 0.794 降到 0.500。训练和评估要使用相同的上下文策略。
- 当预算有余量时,格式错误的调用不付出奖励代价,因此 RL 几乎没有消除它们(从 1.9% 到 1.4% 的轮次)。混合单轮与多轮任务教会了单轮格式(0.256 对 0.000),代价是多轮表现略有下降;在
token_mean下,占 50% 回合的单轮回合只得到 19% 的权重。 - 截断是奖励的一部分:在失败提交记 −1 时,智能体有一段时间停止了提交;而把被截断的回合从损失中掩蔽掉让拖延变得免费(留出 0.075)。所有结果都是在 158k 参数模型上的单随机种子机制演示(mechanism demonstration)。
练习
- 证明在逐调用代价且 时,轮级 GAE 给第 次调用的优势为 。critic 满足什么条件时,它恰好让一次无用的
test调用只承担它自己的代价? - 改变一个假设:从一个先以
max_turns=6训练了 20 步的策略出发,重新运行第 12.3 节的max_turns 3实验。一个已经会阅读的策略在紧张的预算下还会继续阅读吗?这对关于预算的课程设计说明了什么? - 为第 12.4 节的上下文策略实现摘要:把源代码观测替换为
arl.infer_op会选择的操作名。用它训练,并在完整上下文下评估。掩蔽和摘要,哪种上下文策略迁移得更好?为什么? - 按照 Pardo 等人在上限属于任务时的建议,在
EditBudgetEnv的一个副本中把剩余预算加入观测(“turns left 2”),并重复wrong_submit=-1的运行。策略还会拖延吗? - 在第 12.6 节的混合运行中,比较
loss_mode='token_mean'与'seq_mean_token_mean'。在每种设置下哪种格式提升得更快?这如何从上面测得的权重占比推出? - 自举:使用第 12.2 节的 critic,为从不提交运行中因预算而被截断的回合计算 ,并对被截断的回合用 训练。与第 12.7 节的两种处理方式进行比较。
- 设计评审(design review):一个用 50 轮预算和完整上下文训练的 SWE 智能体,在部署时使用 100 轮预算并在 30 轮之后进行观测掩蔽,其解决率下降了。列出其中涉及的分布偏移、能够区分它们的测量,以及你会提议的训练改动。