3.1 从下一个 token 预测到策略
参数为 的语言模型在给定前缀 (提示加上位置 之前的所有 token)时,定义了下一个 token 的分布。对于回复 ,其概率按自回归方式分解: 这一分解让模型同时在两种粒度上成为策略。在 token 级,状态是前缀 ,动作是一个 token 。在轮(turn)级(第 2 章的建模方式),动作 是一整条消息,例如<call> read </call>,它的对数概率是其中各 token 对数概率之和。两种视角使用的是同一组逐 token 数值,区别只在于后续章节如何对这些数值做回报归因(credit assignment)。
模型输出 logits ,每个词表条目一个。下一个 token 的分布是 logits 的 softmax,因此所选 token 的对数概率为
第二项是对数配分函数,它把所选 token 与词表中的所有其他条目耦合在一起。在代码中,这就是沿词表轴做 log_softmax,再用 gather 取出所选索引。批次轴和时间轴原样保留:形状为 [B, T, V] 的 logits 和形状为 [B, T] 的 ids 产生形状为 [B, T] 的对数概率。
gather 根据 ids,从每个位置的全词表分布中取出实际所选 token 的对数概率。例如,logits 为 [B, T, V]、ids 为 [B, T] 时,先用 ids.unsqueeze(-1) 得到索引 [B, T, 1],取值后再用 squeeze(-1) 去掉最后一维,结果就是 [B, T]。归一化仍覆盖整个词表;只取一个值,是因为这一位置只实际采样了一个动作。该函数在归一化之前把半精度 logits 上转为 fp32,第 3.6 节会测量这样做的必要性。
我们用两种方式检验这个函数:一是与每个预训练循环都会计算的负交叉熵比较;二是检验区分对数概率与原始 logit 的性质——给每个 logit 加上同一个常数,分布不变。
陷阱。 logits.gather(...) 之后接一个损失,代码能无错运行,也确实在训练某种东西。但它只提高被选中的 logit,而不会通过配分函数压低其他候选,因此优化的是另一个目标。务必先在整个词表上归一化,再做 gather。
3.2 数值稳定的对数概率与熵
公式 没有问题,直接用浮点数计算却可能上溢或下溢。先算softmax(z) 再取 log 会下溢:当某个 logit 远低于最大值时,它的概率在 fp32 中被舍入为零,对数变为 -inf。直接对大 logit 取指数则会上溢。log-sum-exp 恒等式先减去最大值 ,求和取对数后再加回来,同时消除这两个问题:
现在指数函数的输入都不大于零,因此函数值不超过 1,不会发生上溢;最大的一项恰好贡献 1,因此和不会下溢为零。torch.log_softmax 和 torch.logsumexp 实现的就是这一恒等式。
softmax().log() 给出 -inf,而 log_softmax 返回精确的 。策略梯度代码会把这个值乘以优势(advantage)。后续的乘法、减法等运算可能把 -inf 进一步变成 nan,使整个批次的更新失效。[1000, 999] 的朴素 log-sum-exp 上溢为 inf,平移后的版本返回 。
下一个 token 分布的熵 衡量策略在某个前缀处的分散程度。RL 会持续监控它,因为熵的坍缩意味着策略已经停止探索(第 10 章)。我们同样从 log_softmax 计算熵。有一个细节很重要:top-p 等采样过滤器会把一些 logits 设为 。对这些 token, 且 ,乘积 在浮点数中是 nan。其极限是 0,所以我们显式写出这一点。
nan。最大值 值得记住,可以作为尺度参照。对 Qwen3 的词表,它约为 11.9 nats,而训练好的模型在代码上的逐 token 熵通常只是它的一小部分。
3.3 采样定义了行为策略
部署中的模型很少直接从 采样。推理栈会先变换 logits,而这些变换定义了生成数据的那个策略。标准的变换有三种:- 温度(temperature) 用来除 logits:。 使分布更尖锐, 使分布更平坦, 趋近于贪心解码。
- Top-k 保留最大的 个 logits 并重新归一化。
- Top-p(核采样,nucleus)按概率对 token 排序,保留累计概率达到 的最短前缀,然后重新归一化。
sampling_log_probs 返回采样器的完整对数分布,被排除的 token 为 -inf;sample_next 从中抽样,并返回被抽中 token 在同一分布下的对数概率。
scatter 把丢弃决定从排序后的顺序写回词表顺序。贪心解码被视为确定性策略:在它之下被选 token 的概率为 1,因此对数概率为 0。这个值是正确的,但它也说明了贪心数据为什么不能用于策略梯度估计量(estimator):该策略给它本可能探索的每一个候选都赋予零概率。
下一段代码在三种设置下各从同一个六 token 分布中抽取 20,000 个样本,并把经验频率与 sampling_log_probs 报告的概率进行比较。
 图 3.1 展示了温度的两种效应。左图中,每条曲线都从 0(贪心)单调上升,趋向上限 。更尖锐的 logits(更大的尺度)需要更高的温度才能达到相同的熵。右图展示了机制:降低 会提高高概率 token 的占比,升高 则会提高尾部 token 的占比。因此 rollout 温度直接设定了 RL 的探索(exploration)水平,第 10 章讨论熵坍缩时会回到这一点。
3.4 TinyAgent
本书其余部分需要一个策略:它要小到能在 CPU 上用大约一分钟完成 RL 训练,又必须是真正的自回归 transformer,这样我们研究的每一种现象(格式学习、熵坍缩、奖励投机(reward hacking)、长度效应)都源自与大模型相同的机制。TinyAgent 是一个 pre-norm 的仅解码器 transformer,使用可学习的位置嵌入、因果掩码和不共享权重的输出头。后续章节唯一依赖的是它的接口:输入 ids[B, T],输出 logits [B, T, V]。rollout(第 5 章)接受任何具有该接口的模块。
我们使用 PyTorch 的 nn.TransformerEncoderLayer 加上因果掩码,而不是手写注意力。读者已经熟悉 transformer 块,而本书的主题是它周围发生的事情。本书关闭 dropout,让采样器和训练器能复现同一分布下的概率;否则,还需要处理随机掩码带来的差异。第 3.7 节展示不一致的代价。
sequence_log_probs 把模型与训练目标连接起来。它对一条完整序列做一次前向传播,返回第一个 token 之后每个 token 的对数概率。位置 的 logits 预测 token ,因此 logits 截去末尾,ids 截去开头。输出形状为 [B, T-1],第 列对应 token ids[:, j+1],并不是 ids[:, j]。本书的每一个掩码和每一个存储的对数概率都使用这种对齐方式,我们称之为被预测位置(predicted positions)。
3.5 不带 KV 缓存的生成循环
要行动,策略就必须生成。最简单的正确生成器在整个前缀上调用模型,从最后一个位置的 logits 中采样下一个 token,将其追加到序列末尾,然后重复。它在每一步都重算所有之前的位置,因此不需要键值(KV)缓存。我们记录采样器给每个 token 的对数概率,因为这个数就是行为策略对该动作的概率;一旦采样设置丢失,训练器就无法重建它。3.6 真实词表:Qwen3-0.6B
TinyAgent 的词表足够小,[B, T, V] logits 张量可以忽略不计。在真实模型中,它往往是一步中最大的激活。我们从检查主机的本地缓存加载 Qwen3-0.6B 的分词器(tokenizer)和配置,不下载任何东西。
log_softmax 会再物化一个同样大小的张量,autograd 还要保留反向传播所需的内容。一个典型的、包含 64 条长轨迹(trajectory)的智能体强化学习(agentic RL)批次将需要 TB 级的显存。相比之下,模型权重本身(0.6 B 参数)只是零头。
在处理显存问题之前,我们先看看这些对数概率说明了什么。下一段代码在 CPU 上以 fp32 加载模型,逐 token 地给第 1 章中有缺陷的 clamp 及其修复版本打分。
return 行的函数体。模型认为有缺陷的函数体可能性低得多:在有缺陷的版本中,min 和 (lower 分别花费 4.03 和 5.17 nats,而在修复版本中,max 和 (lower 只花费 0.90 和 0.26。两者的序列对数概率相差超过 10 nats。预训练模型已经带有关于正确代码长什么样的先验,而在编码任务上做 RL 是从这个先验出发的,而不是从未训练的 TinyAgent 那种近似均匀的策略出发。
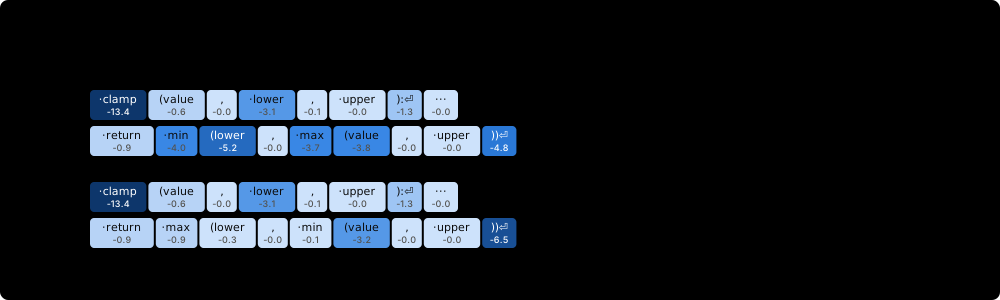 图 3.2 把同样的数字画成两条 token 条带。从左向右读。两行中的函数签名完全相同,包括模型赋予很低概率的第一个 token
clamp(没有任何上下文可以预测函数名)。两行在 min 和 max 处出现差异;有缺陷的那行颜色更暗,表示这些 token 的概率更低。结尾的 ))\n 在两行中都不太可能,因为模型预期函数还会继续。
现在来看显存。所选 token 的对数概率并不需要一次性得到完整的 [B, T, V] 张量。输出层是最终隐藏状态 [B, T, D] 与嵌入矩阵 [V, D] 的矩阵乘积,所以我们可以沿时间轴分块处理。每个块构建自己的 logits,归一化,gather 所选 token,然后丢弃 logits。logits 的峰值显存从 降为 ,其中 为块长度。
 图 3.3 把每个 token 的误差相对于其 fp32 对数概率画出。这段代码重复性很强,所以 499 个 token 中的大多数都以接近确定的方式被预测,聚集在右侧,误差低于 0.05 nats。最大的误差(最高 0.13 nats)属于模型认为不太可能的少数 token,在那里 logits 的微小变化会让对数概率移动更多。这些低概率 token 正是 RL 最想强化或抑制的探索性动作,所以精度误差恰恰集中在学习信号所在之处。
3.7 实践中的设计问题
问题:rollout 与训练之间的温度不一致。 现象: 在一次 rollout 之后的第一个优化步,尚未有任何参数改变,PPO 比率就已不为 1,近似 KL 已经为正。在一个根本没有移动的策略上,裁剪比例(clip fraction)不为零。 原因: 采样器从 中抽取 token,而训练器用 给它们打分。二者是不同的策略(第 3.5 节在一个近似均匀的模型上测得最高 0.48 nats 的差距,而差距会随 logits 的尖锐程度增大)。 可选方案: (a) 以 采样 RL rollout,代价是可能失去低温采样带来的质量收益。(b) 把训练器的 logits 除以相同的 ,代价很低,但必须应用于所有计算对数概率的地方,包括参考模型和熵。(c) 把 rollout 当作 off-policy 数据,用重要性权重校正,这会增加方差。 建议做法: 本书在训练中以 采样,并使用 rollout 存储的采样对数概率,这样不一致会表现为可测量的比率,而不是无声的偏差。如果部署需要 ,就在训练器中施加相同的 。下一段代码复现这一症状:以 采样的 token 由未加温度的训练器打分,在没有任何更新的情况下得到远离 1 的比率。
问题:top-p 截断使对数概率无定义。 现象: 重要性比率或 KL 估计中出现inf或nan,通常只在少数 token 上。 原因: 在 top-p 或 top-k 下,行为分布 给保留集合之外的 token 恰好赋予概率 0,因此 。任何除以 、或在另一个分布采样出的 token 上计算 的量都会出错。更隐蔽的是, 在 概率为零的位置仍有非零概率,所以无论抽取多少样本,基于 的重要性采样(importance sampling)都根本无法估计 下的期望。 可选方案: (a) 训练 rollout 不做截断采样。(b) 存储截断(或以完全相同的方式重算),并在截断后的支撑集上评估训练器的策略,这会把目标改成截断后策略的目标。(c) 对比率极端的 token 做裁剪或掩码,这只是掩盖问题。 建议做法: 训练 rollout 中不使用 top-p 或 top-k。只在评估和部署时截断。
问题:bf16 对数概率的精度。 现象: 在第 0 步,逐 token 比率就在 1 附近散布几个百分点;即使策略就是参考策略,与参考模型之间的 KL 也从不恰好为 0。 原因: bf16 只有 8 位尾数。第 3.6 节在 Qwen3-0.6B 上测得平均每个 token 误差 0.003 nats,单个 token 比率在 0.955 到 1.135 之间,在 499 个 token 上序列级差距为 0.52 nats。 可选方案: (a) 在 fp32 中计算输出层和 log-softmax(如selected_log_probs对半精度输入所做的那样),成本很低。(b) 重算对数概率时整个模型都用 fp32,这大约使显存和时间翻倍。(c) 在训练器中重算行为对数概率,而不是信任引擎给出的值,并校正剩余的不一致(第 13 章)。 建议做法: 始终在 fp32 中归一化。当引擎和训练器使用不同内核时,在训练器中重算old_logp,并把第 0 步的比率作为运行指标来监控。
问题:[B, T, V] logits 的显存爆炸。
现象: 只在训练中途回复长度增长时才出现的显存不足(OOM)错误。智能体强化学习会随时间拉长回复,所以在第 100 步能装下的运行到第 2,000 步就会失败。
原因: logits 张量按 增长,而 Qwen3 的 约为 152k。第 3.6 节算出 8 条 4,096 token 的序列需要 20 GB。
可选方案: (a) 沿时间轴分块(第 3.6 节),在反向传播中重算各块。(b) 使用从不物化 logits 的融合线性层加 log-softmax 内核。(c) 只在动作位置计算 logits,因为工具输出 token 没有损失(第 5 章),当观测(observation)占据大部分上下文时这样节省最多。(d) 减小微批次(micro-batch)大小,这会降低吞吐量。
建议做法: 从一开始就使用分块或融合的对数概率计算,并结合按 token 预算确定的批大小(第 14 章),而不是固定的序列条数。
小结
- 语言模型在 token 级是一个策略,通过对 token 对数概率求和,在轮级也是一个策略。所选 token 的对数概率是 ,用
log_softmax和gather计算,它等于负交叉熵。 - 用 log-sum-exp 计算对数概率和熵,绝不要用
softmax().log()。当过滤器把 logits 设为 时,要显式处理 。 - 温度、top-k 和 top-p 定义了行为策略。
sample_next返回在实际采样分布下的对数概率;给同样的 token 打分的训练器必须使用同样的变换,否则就要把数据当作 off-policy 数据处理。 - TinyAgent 是一个 15.8 万参数的因果 transformer,接口为 ids
[B, T]→ logits[B, T, V]。sequence_log_probs把它的输出对齐到被预测位置ids[:, 1:]。 - 在生产级词表规模下,logits 张量主导显存,因此必须使用分块或融合的对数概率计算。bf16 对数概率与 fp32 平均每个 token 相差约 0.003 nats,单个 token 上最多相差 0.13 nats,且误差会在序列上累积(本书在 Qwen3-0.6B 上测得)。
练习
- 在
sampling_log_probs的副本中加入top_k参数,并像第 3.3 节那样用 20,000 个样本验证经验频率是否一致。当剩余的 个 logits 相等时,top-k 分布的熵是多少? - 改变一个假设:训练时的 dropout。给 TinyAgent 设置
dropout=0.1,置于训练模式,然后在温度 1 下重复第 3.5 节的采样器/训练器比较。现在第 0 步比率的散布有多大?这对 RL 期间使用 dropout 意味着什么? - 对 计算 argmax token 的
sampling_log_probs,以此说明贪心解码是温度采样在 时的极限。解释为什么贪心 rollout 给出的策略梯度为零。 - 扩展第 3.6 节:在 bf16 中计算对数概率,并且 log-softmax 也用 bf16(跳过上转)。误差会大多少?哪些 token 受影响最大?
- 利用
chunked_log_probs,编写一个只在给定掩码为 1 的位置计算对数概率的版本。对于 80% 的 token 都是工具输出的轨迹,logits 的峰值显存会下降多少? - 设计评审(design review):一位同事提议只存储推理引擎采样出的 token ids,并在训练器中重算所有对数概率,“因为权重是一样的”。列出这种做法精确成立的条件、它会悄悄改变目标的条件(温度、top-p、精度、内核),以及你会在监控面板上添加什么指标来检测违反情况。