edit 和多余的第二次 swap_minmax 会获得相同的正向反馈,策略因此学会叠加编辑。本章讨论怎样改进这个学习权重。
这两个问题都与奖励如何转成学习权重有关。策略梯度定理允许使用任何满足以下条件的权重:在给定历史和动作时,它的期望等于该动作的优势(advantage),即该动作比策略在这一状态下的平均表现好多少。本章构建生产系统所用的各种优势估计量:剩余回报(return-to-go)、时序差分误差与 步回报、广义优势估计(GAE),以及 GRPO 和 RLOO 中不需要 critic 的组基线。每个估计量都在带掩码的 token 序列上实现,使价值和优势只存在于策略 token 上,递推则跳过工具片段。我们还会在 TinyAgent 上训练一个 critic(价值模型),测量 critic 为何难以用于语言智能体;最后讨论轮级优势,并在一个真实的多轮回合上逐 token 画出来。
sample 对每个任务同步采样 n_per_task 个回合,使相邻的回合构成对同一任务的一组(group)尝试。
7.1 token 序列上的剩余回报
6.5 节说明,一个动作的学习权重只需包含从它发生时起的奖励,即剩余回报 。在 token 序列上计算它之前,需要回答两个问题:奖励放在哪里?什么算作一个时间步? 本书的约定同时回答了这两个问题。先约定奖励记在哪个位置:把它记在触发这次奖励的调用末尾。终局结果放在回合的最后一个策略 token 上,在 BugFix 轨迹中就是最后一次调用的</call>;每次调用的代价放在该调用的最后一个 token 上。时间只在策略 token 上推进。提示、模板和工具 token 不是动作,因此不是决策过程的步:递推跨过它们, 每个策略 token 只施加一次。当 时(本书对有限长度编程回合的默认设置,见 2.9 节),时间单位的选择无关紧要;当 时则有影响,7.7 节会再谈这一点。
outcome_rewards 把每条轨迹的一个奖励放到它的最后一个策略 token 上,这是本章所有估计量的输入格式。
7.2 价值、TD 误差与 n 步回报
对于它之前的那个动作,剩余回报是 的无偏样本,但噪声很大:它携带了之后每个动作和每次观测的全部随机性。价值函数(value function)通过对这些随机性取平均来消除它。对于在策略 token 之前结束的前缀 ,token 级价值为 即从该点起的期望回报。它只在即将做出决策的地方有定义,也就是策略位置上。记 为 之后的下一个策略位置。在一次调用内部,,转移是确定性的。在调用结束时, 还包含工具的响应,而它是随机的。两种情况下都有 时序差分(TD)误差(temporal-difference error)用我们手头仅有的一个样本代替这个期望: 如果 ,则 :单个 TD 误差就是优势的无偏估计,并且它只包含一次转移的随机性,而不是回合剩余部分的随机性。介于两个极端之间的是 步回报(-step return), 它使用 个真实奖励,然后从价值函数自举(bootstrap)。 给出 , 给出剩余回报。 越大,越少信任 critic、越多信任样本:在 有误时偏差更小,方差更大。 我们在第 2 章的修复 MDP 上验证 TD 恒等式,在那里 和 都可以精确求得。sample_steps 并行运行多个回合,并按与 token 批次相同的 [B, T] 布局记录它们:状态、动作、奖励,以及在回合进行期间为 1 的掩码。
7.3 广义优势估计
每个 步回报都给出一个优势估计 。记 为 之后第 个策略位置,用裂项求和可以把它改写为 TD 误差之和: 中间的价值两两相消,剩下 个奖励、自举价值 和 。广义优势估计(generalized advantage estimation,GAE;Schulman et al., 2015)以几何权重 对它们取平均: 第二个等号通过交换求和顺序得到: 出现在所有 的 中,总权重为 。这就是式 (7.1)。有两个特例可以作为锚点。当 时,,即一步 TD 误差:方差最低,但只要 有误就有偏差。当 时,求和完全裂项为 ,即剩余回报减去基线:无论 是什么,它对策略梯度都是无偏的,因为此时 只是一个基线(式 6.3),同时它带有回报的全部方差。 在两者之间权衡。这个和还有一行的递推形式,实际就是这样计算的: 带掩码的实现需要跨过非策略位置反向携带两个量:下一个策略位置的价值( 需要它),以及该位置的优势(递推需要它)。函数还返回价值目标(value target),第 8 章用它来训练 critic。-0.0 只是零的舍入结果)。当 时,位置 1(第一次调用的最后一个 token)的优势是 :它从下一个策略位置的价值 0.6 自举,而不是从位置 2 上的垃圾值 9 自举。朴素递推走进工具片段,为这个 token 算出 ,为第二次调用的最后一个 token 算出 8.2。在真实系统中,critic 在工具位置上的输出不会是 9,而是看起来合理的未训练数值,所以这个 bug 会改变训练,却不会让它崩溃。
λ 如何影响偏差与方差
会带来多少偏差,取决于 critic 错得有多离谱。在修复 MDP 上,我们可以直接测量策略梯度本身的偏差(这才是要紧的量),并与 autograd 算出的精确梯度比较。每个回合贡献 ,对于 softmax 表格策略,这个得分在第 行上是 。我们比较三个 critic:精确的 ;一个陈旧的 critic,即均匀策略的精确价值,它扮演尚未跟上当前策略的 critic;以及完全没有 critic,。gae_advantages 的是 critic 对访问过的状态给出的价值 critic[states]。函数看到的布局与 token 批次相同,都是 [B, T],所以这和在 TinyAgent 上运行的是同一段代码。
 表格和图 7.1 展示了这一权衡。使用精确 critic 时,对每个 ,相对偏差都不超过约 0.03 的蒙特卡洛噪声底,正如 TD 恒等式所预测的;而方差从 到 增长了将近五倍(0.072 到 0.341)。使用陈旧 critic 时, 的偏差达到梯度范数的 16%,到 时降到噪声底。没有 critic 时, 只用到即时的步代价而忽略了结果,所以偏差是 74%,即使 也还剩 10%。所有列在 处汇合:此时 critic 只是一个基线,三个估计都无偏,方差的差别只在于各自作为基线有多好。这个例子说明了偏差与方差的取舍:增大 会减少对 critic 的依赖,但通常增加方差。该取多少,取决于 critic 的准确性,而这正是语言智能体中的难点。
7.4 训练 critic
GAE 需要每条轨迹每个策略位置上的 。对语言智能体,标准做法是用一个价值模型(value model):与策略同架构的 Transformer,其输出层只有一个单元而不是 个,通过在价值目标上做回归来训练。make_critic 复制一个 TinyAgent 并替换它的输出头来构造价值模型。critic_values 把输出与被预测的位置对齐:第 列的价值是 critic 在位置 的输出,它看到的是直到 token 的前缀,恰好就是选择 token 时的上下文。
swap_minmax 修好了 limit,然后读取、应用漏洞利用 hardcode_tests(这里无害,因为 bug 已经修好),再提交。critic 的价值并没有跟踪这一进展。它们在决定性的编辑之后上升,从 0.278 到 0.397,随后却在一次成功的提交之前下降到 0.137。critic 必须仅凭 token 推断某次编辑是否修好了 bug,而这取决于它从未见过的隐藏测试。这就是 2.7 节中的部分可观测性,现在出现在 critic 身上。
这些困难在规模扩大时会叠加,这也是公开的 LLM 强化学习配方以不依赖 critic 的方法为主的原因。与策略同规模的 critic 会使训练的内存和计算翻倍。它的目标是长回合的二值结果,这几乎是回归的最坏情形。它必须跟踪一个每步都在变化的策略,所以总是多少有些陈旧,而由图 7.1 可知,这正是小 有害的情形。它还必须从某处初始化:要么从策略初始化,策略懂文本却从未预测过标量;要么从奖励模型初始化,奖励模型能预测质量,却不是在这个策略下的质量(7.7 节)。基于价值的方法仍在使用,例如在 PPO 流水线中,以及在针对长时程回报归因的工作中(第 20 章),但它们每一个都必须先解决这些问题。
7.5 用组内样本构造基线
如果 critic 既昂贵又不准确,就从数据中取基线。对于结果奖励且 ,若用任务初始价值作为统一基线,轨迹 的每个策略 token 都使用 。这里的 是当前策略在该任务上的期望奖励,可以通过多次采样来估计;它不再区分回合内部的前缀。第 6 章的按任务基线用一个独立批次做到了这一点。组方法在同一步中对每个任务采样 次尝试,并直接使用这一组本身。 组均值(group mean)基线(GRPO,DeepSeekMath;Shao et al., 2024)使用 ,其中 是组内均值;GRPO 还会再除以组内标准差。均值包含了 自身,因此略微违反了式 (6.3) 的条件。留一(leave-one-out)基线(RLOO;Kool et al., 2019,以及面向 LLM 的 Ahmadian et al., 2024)把它排除在外: 第二种形式是一个两行就能推出的恒等式,它解决了偏差问题。组均值优势恰好是 RLOO 优势的 倍,而 RLOO 是无偏的,因为另外 个样本与 独立。所以组均值在相差一个常数因子的意义下是无偏的,而这个因子会被学习率吸收。两个函数都接受按连续group_size 个一组排列的奖励 [B]。
group_advantages 除以样本标准差(带 Bessel 校正),与 torch.std 以及常见的开源 GRPO 实现一致。附录 B 的问题 4 使用总体标准差,二者相差因子 。用一组八个样本、其中仅一次成功的例子,比较这三种变体。
标准差归一化与难度偏差
除以组内标准差使每一组的优势都具有单位尺度。对于二值奖励,若 次尝试中有 次成功,成功比例为 ,总体标准差为 ,归一化把这一组去均值后的优势大约乘以 。这个因子在 时最小,为 2,当 趋近 0 或 1 时无界增长。Liu et al. (2025) 在提出 Dr. GRPO 的论文中把这称为题目级的难度偏差(difficulty bias):策略几乎总是失败或几乎总是解决的任务,每个回合得到的更新比中等难度的任务更大。他们的补救办法是去掉这个除法,同时去掉 6.6 节分析过的按序列长度归一化。 这一偏差很容易量化。对于真实通过率为 的任务,一组中的成功次数服从二项分布。我们计算一组八个样本的期望总绝对优势(它决定了该任务对参数的推动有多大),分别在有和没有归一化的情况下。 没有归一化时,任务的期望更新强度在通过率为一半时达到峰值,在两端消失,这正是无偏梯度的行为:策略总能解决的任务已经没有什么可教的了。
有归一化时,每个任务的更新强度都更大,而且放大因子依赖于难度:在 时为 1.98,在 时升至 2.49,在 时为 2.64。以一组携带任何信号为条件,这一效应更明显:使用样本标准差时,八次中成功一次的组被放大 2.83 倍,成功四次的组被放大 1.87 倍。因此,相对于无偏梯度,归一化把权重移向最难和最容易的任务,在期望意义下, 处约多出三分之一。期望更新强度在两端仍然消失,因为那里的大多数组方差为零。图 7.2 画出了两条曲线及其比值。
这种放大是否有害,取决于那些罕见的成功是什么。如果它们是真正的修复,放大它们就是一种课程学习。如果它们是侥幸猜中、不稳定测试或漏洞利用,归一化放大的恰恰是最不想训练的噪声。一些公开的编程智能体配方去掉了这个除法(第 20 章),第 9 章在 TinyAgent 上比较了两者。
7.6 轮级优势
到目前为止,每个估计量用于结果奖励时,给每个 token 的数值只通过 critic 依赖于它的位置。没有 critic 时,回合中每个策略 token 的优势都相同。这就是 2.8 节中的回合级建模,其代价随回合变长而增长:在一条 50 轮的轨迹中,一次无用的read 和决定性的 edit 得到相同的信号,只有对许多回合取平均才能把它们区分开。
对工具交互而言,按轮分析动作的贡献更自然。轮级优势(turn-level advantage)为每次调用分配一个数值,由该调用的所有 token 共享。有 critic 时,每轮开始处状态的价值给出轮级 TD 误差 ,而轮级 GAE 以每次调用一步(而不是每个 token 一步)运行式 (7.1) 的递推。在一次调用内部,各 token 不单独分配学习信号:这次调用作为整体成功或失败。turn_advantages 从 token 张量构建轮级序列,在其上运行 gae_advantages,再把结果广播回各个 token。
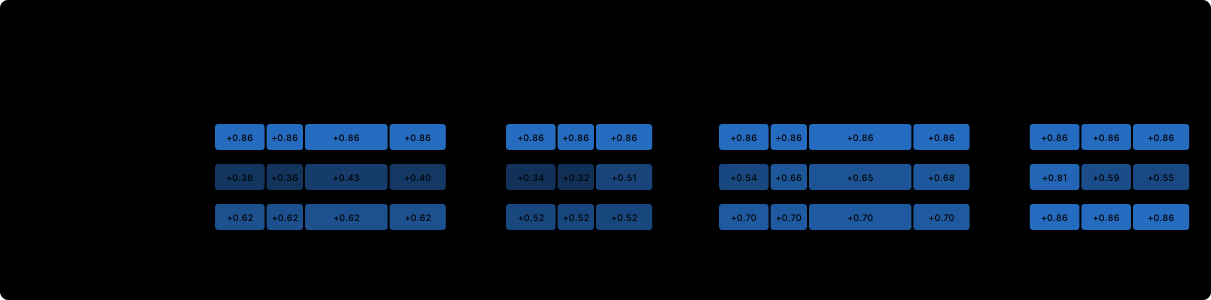 图 7.3 逐 token 画出了同样的数值。结果行是均匀的:这个成功回合的每次调用都得到 ,决定性的
swap_minmax、无用的 read 和漏洞利用 hardcode_tests 都一样。两行基于 critic 的结果在不同调用之间有差异,因为每次调用的学习信号取决于即时奖励和前后状态的价值估计。在这个 critic 下,它们把回报归因反了:决定性的编辑在两行中都得到最少的正向学习信号(token 级 0.39,轮级 0.62),而漏洞利用和提交得到的最多。这正是上一节那个 critic 在起作用:修复之后它的价值下降了,于是修复之后的步相对于一个悲观的基线看起来像是改进。token 级 GAE 还在一次调用内部变化,变化来自 critic 价值在相邻 token 之间的微小改变,这些大多是噪声:在 <call> edit swap_minmax </call> 中,只有操作 token 是真正的决策。轮级 GAE 从构造上消除了这种调用内噪声。
这些行都不是动作贡献的真值。基于 critic 的估计受限于 critic 的准确性:如果它在新回合上只能解释百分之几的方差,给出的学习权重可能还不如统一的结果权重。这些条带展示的是每种方案能够表达的结构。纯结果级的学习信号无法区分同一回合中的不同调用,这种区分只能来自回合之间的比较。轮级归因可以做到,前提是在调用边界处有可用的评价信号:critic、过程奖励模型,或者给中间状态打分的验证器。当前关于长时程回报归因的研究正集中于此(第 12 章,第 20 章)。
7.7 实践中的设计问题
问题:零方差组。 现象: 每个批次中有很大一部分的优势恰好为零,有效批次大小远小于名义批次大小,在总是失败的任务上学习停滞。 原因: 在二值奖励和组基线下,所有尝试都失败或都通过的组方差为零(7.5 节);对通过率为 的任务,其概率为 。 可选方案: (a) 更大的组,rollout 成本线性增长。(b) 过滤零方差组,并用新样本补满批次(动态采样,第 9 章),这需要额外的 rollout,并引入偏向中等难度任务的采样偏差。(c) 按通过率安排课程(第 14 章)。(d) 部分得分奖励,有被投机利用的风险(第 11 章)。 建议做法: 每步记录零方差比例;超过约三分之一时,过滤并补满。在 的基座智能体上,7.5 节直接测得:20 组中有 6 组(30% 的回合)方差为零,全部是全失败组。
问题:critic 的初始化。 现象: critic 的解释方差在许多步内都接近零,小 下的 GAE 优势被 critic 噪声主导,早期训练不稳定或缓慢。 原因: 从策略初始化的 critic 了解文本分布,却从未预测过标量;它的新输出头从零信息开始。从奖励模型初始化的 critic 能预测质量,但价值是策略的属性,而奖励模型从未见过这个策略。 可选方案: (a) 从策略初始化,并在策略更新开始之前单独预热 critic 若干步。(b) 从奖励模型初始化,当奖励模型就是奖励本身时这有帮助。(c) 早期使用 ,此时 critic 只是基线,不会使梯度有偏;随着 critic 改进再降低 。(d) 去掉 critic,使用组基线。 建议做法: 对结果奖励的编码任务用 (d);如果需要 critic,用 (a) 加 (c),并以其解释方差作为门控条件。7.4 节在同一数据上测量了从策略初始化和从头初始化,两者在新回合上的解释方差都没有超过 0.08。
问题:长时程下的 γ 与 λ。 现象: 使用 token 级 GAE 时,长回合的早期 token 几乎得不到来自最终结果的学习信号,策略只在回合末尾附近学习。 原因: GAE 对 个策略 token 之后的 TD 误差施加权重 。结果只能经由 到结尾之间的 critic 价值链传到 token ,而直接路径按几何级数衰减。 可选方案: (a) ,使优势成为回报减去基线,许多 LLM 的 PPO 配置都这样做。(b) 轮级 GAE,按调用而不是按 token 施加衰减。(c) 需要紧迫性时,按轮而不是按 token 折扣。 建议做法: (a) 或 (b)。下面的代码块显示直接路径给予 个策略 token 之外的结果的权重。
问题:在整个批次上白化还是在组内白化。 现象: 即使没有采样到对困难任务更好的尝试,所有针对困难任务的尝试也都被压低;简单任务上的成功与困难任务上罕见的成功被同样用力地推高。 原因: 在整个批次上归一化奖励,是把一次尝试与针对其他任务的尝试做比较。于是它的优势反映任务难度的程度不亚于反映尝试的质量。 可选方案: (a) 在组内中心化,比较针对同一任务的尝试。(b) 先在组内中心化,再除以批次标准差,这样既保留了组内比较、获得稳定的步长,又不会引入 7.5 节那种按组的难度加权。(c) 只做批次白化,仅当每个批次只有一个任务或有学习到的按任务基线时才可接受。 建议做法: (b)。下面的代码块在基座智能体的组上比较批次白化与组内中心化。
问题:结果优势奖励无用的步。 现象: 训练过程中成功回合越来越长,出现多余的读取、重复的测试或重复的编辑,同时通过率在上升。第 6 章的 REINFORCE 运行学会了堆叠编辑。 原因: 纯结果优势由成功回合的每次调用共享,所以一次什么也没改变的调用,与修好 bug 的那次调用被同样强烈地强化。只有与其他回合比较(无用的调用也出现在失败回合中)才能消除它,而这种比较有噪声。 可选方案: (a) 每次调用设一个小代价,这会改变任务,并且需要与有用的信息收集相权衡来调节(第 12 章)。(b) 来自 critic 或过程奖励的轮级优势。(c) 接受它并依靠平均,同时记录轮数和 token 数。 建议做法: 起初用 (c) 并记录日志,之后用 (a),代价要小到 oracle 的四次调用仍然划算。下面的代码块测量基座智能体的成功回合中,有多少正优势落在既不是正确编辑、也不是最终提交的调用上。
小结
- 奖励记在触发它的调用末尾 token 上,时间只在策略 token 上推进,每个递推都把状态原样携带过工具片段。
returns_to_go和gae_advantages用掩码实现了这一点;逐个走过工具位置的朴素递推会从无意义的数值自举。 - 当 critic 精确时,TD 误差 是优势的无偏估计。GAE 把各个 步估计平均为 : 方差低,但受 critic 误差影响而有偏; 是回报减去基线,对任何 critic 都无偏。在修复 MDP 上,陈旧 critic 在 时使梯度严重有偏,随着 偏差消失,而方差增大。
- 在 480 个基座智能体回合上训练的 TinyAgent 规模 critic,在其训练回合上最多解释 22% 的方差,在新回合上最多 8%:给定前缀后二值结果仍有很大噪声,critic 会过拟合,而且它看不到隐藏测试。在一个真实回合上,它给决定性的编辑分配了最少的正向学习信号。
- 组基线用针对同一任务的其他尝试代替 critic。组均值恰好是无偏的留一(RLOO)优势的 倍。除以组内标准差会把八次中成功一次的组放大 2.83 倍,把成功四次的组放大 1.87 倍,相对于无偏梯度,把权重移向最难和最容易的任务;Dr. GRPO 去掉了这个除法。零方差组在 时占基座智能体回合的 30%,不携带任何梯度。
- 轮级优势给整次调用分配学习信号并消除调用内噪声,但需要在轮边界上有价值。纯结果优势给成功回合的每次调用相同的学习信号,无用的步就是这样被强化的。
练习
- 用裂项求和证明 ,并证明即使 有误, 的 GAE 也等于 。然后证明 的 GAE 的偏差为 (在下标约定上可能略有出入),并用 7.3 节的陈旧 critic 一列检验这个表达式。
- 改变一个假设:让
gae_advantages像朴素版本那样走过每个位置,但把 critic 在工具位置上的价值设为前一个策略 token 的价值。当 时,它现在与带掩码的版本等价吗? 时呢?请解释。 - 把 7.4 节的 critic 训练 600 步,画出训练回合和新回合上的解释方差随步数的变化。它从哪里开始过拟合?用五倍数量的回合重复实验。
- 证明 严格成立,并计算组均值估计量的期望梯度。然后构造两个通过率不同的任务,证明经标准差归一化的估计量一般不与 成比例。
- 利用 7.5 节的二项分布计算,求出使通过率为 0.1 的任务的零方差概率低于 0.25 的组大小 。对 64 个任务而言,这意味着每步需要多少次 rollout?
- 实现一个不需要 critic 的轮级优势:用当前策略从每个轮边界的前缀出发运行 次续写,以此估计该处的价值(蒙特卡洛 rollout 价值,类似 VinePPO 一类的方法)。在 7.6 节的回合上以 应用它。它的逐调用分布与 critic 的相比如何?在 rollout 上要付出多少代价?
- 设计评审:你的团队用 GRPO 和结果奖励训练一个 64 轮的 SWE 智能体。一位同事提议加入价值模型以获得轮级归因。列出要使这一做法胜过组基线,critic 必须满足哪些条件(解释方差、陈旧度、内存),在同意之前你会要求哪些测量,以及一个更便宜的中间步骤。